6.S081 Lab: page tables
本次实验将深入探讨虚拟内存与页表。
[easy] Print a page table
本节需要实现在内核启动时打印初始页表的功能。
定义一个名为 vmprint() 的函数。它应该接受一个 pagetable_t 参数,并按照下面描述的格式打印该页表。在 exec.c 中,在
return argc之前插入if(p->pid==1) vmprint(p->pagetable),以打印第一个进程的页表。如果你通过 make grade 的 pte printout 测试,你将获得本作业的满分。
你可以把
vmprint()放在kernel/vm.c中。使用kernel/riscv.h文件末尾的宏。
函数
freewalk可能会给你一些启发。在kernel/defs.h中定义
vmprint的原型,这样你就可以从exec.c中调用它。在你的printf调用中使用%p来打印完整的64位十六进制PTE和地址,如示例所示。
由于这个需要根据页表的深度打印出对应数量的 .. ,并且页表也没有什么标志位可以判断位于哪一层页表,所以使用递归来记录一个 depth 参数,每递归一次传入的参数都会递增。
void
printpte(pagetable_t pagetable, int depth)
{
for(int i = 0; i< 512; i++) {
pte_t pte = pagetable[i];
if(pte & PTE_V && depth <= 3){
for(int j = 1; j < depth; j++) {
printf(".. ");
}
uint64 pa = PTE2PA(pte);
printf("..%d: pte %p pa %p\n", i, pte, pa);
printpte((pagetable_t)pa, depth+1);
}
}
}
void
vmprint(pagetable_t pagetable)
{
printf("page table %p\n", pagetable);
printpte(pagetable, 1);
}这里我用 depth 来限制了递归的深度,其实不够优雅,最好是根据当前 PTE 的 PPN 指向的是不是为叶子节点进行判断。这样还可以将打印逻辑和递归逻辑进行拆分。
void
printpte(pagetable_t pagetable, int depth)
{
for(int i = 0; i< 512; i++) {
pte_t pte = pagetable[i];
if (pte & PTE_V) {
for(int j = 1; j < depth; j++) {
printf(".. ");
}
uint64 pa = PTE2PA(pte);
printf("..%d: pte %p pa %p\n", i, pte, pa);
if((pte & (PTE_R|PTE_W|PTE_X)) == 0){
printpte((pagetable_t)pa, depth+1);
}
}
}
}[hard] A kernel page table per process
这一节需要为每一个进程拷贝一个专属的内核页表,以为后面第三节中内核可以直接解引用用户指针作准备。
你的第一项任务是修改内核,使得每个进程在内核中执行时都使用自己的内核页表副本。修改
struct proc,为每个进程维护一个内核页表,并修改调度器,使其在切换进程时也切换内核页表。对于这一步,每个每进程内核页表都应与现有的全局内核页表完全相同。如果usertests能正确运行,你就通过了这一部分实验。
向
struct proc中添加一个字段,用于保存该进程的内核页表。为新进程生成内核页表的一个合理方式是:实现一个修改版的
kvminit,它创建一个新的页表,而不是修改kernel_pagetable。你需要从allocproc中调用这个函数。确保每个进程的内核页表都包含该进程内核栈的映射。在未修改的 xv6 中,所有内核栈都是在
procinit中建立的。你需要将这部分功能中的一部分或全部移到allocproc中。修改
scheduler(),将该进程的内核页表加载到当前核心的satp寄存器中(可以参考kvminithart的做法)。不要忘记在调用w_satp()之后调用sfence_vma()。当没有进程在运行时,
scheduler()应使用kernel_pagetable。在
freeproc中释放进程的内核页表。你需要一种既能释放页表、又不会同时释放叶子物理内存页的方法。
vmprint可能有助于调试页表。可以修改 xv6 的函数或添加新函数;你很可能至少需要在
kernel/vm.c和kernel/proc.c中进行修改。(但是,不要修改kernel/vmcopyin.c、kernel/stats.c、user/usertests.c和user/stats.c。)缺少页表映射很可能导致内核遇到缺页异常。它会打印一条错误信息,其中包含
sepc=0x00000000XXXXXXXX。你可以通过在kernel/kernel.asm中搜索XXXXXXXX来找出发生故障的位置。
首先需要在 proc 进程结构体中定义内核页表字段。
pagetable_t kpagetable;需要模仿 kvminit 函数,用于在 allocproc 创建新进程时初始化一个新内核页表拷贝。所以我在 proc.c 下模仿 proc_pagetable 函数定义了一个 proc_kpagetable 。与原版 kvminit 不同的是需要映射 trapframe 和进程的内核栈,这两个部分在内核中每个进程都有专属的部分。
pagetable_t
proc_kpagetable(struct proc *p)
{
pagetable_t kpagetable;
kpagetable = (pagetable_t) kalloc();
if(kpagetable == 0)
return 0;
memset(kpagetable, 0, PGSIZE);
kvmmap(kpagetable, UART0, UART0, PGSIZE, PTE_R | PTE_W);
kvmmap(kpagetable, VIRTIO0, VIRTIO0, PGSIZE, PTE_R | PTE_W);
kvmmap(kpagetable, PLIC, PLIC, 0x400000, PTE_R | PTE_W);
kvmmap(kpagetable, KERNBASE, KERNBASE, (uint64)etext-KERNBASE, PTE_R | PTE_X);
kvmmap(kpagetable, (uint64)etext, (uint64)etext, PHYSTOP-(uint64)etext, PTE_R | PTE_W);
kvmmap(kpagetable, TRAMPOLINE, (uint64)trampoline, PGSIZE, PTE_R | PTE_X);
kvmmap(kpagetable, TRAPFRAME, (uint64)(p->trapframe), PGSIZE, PTE_R | PTE_W);
kvmmap(kpagetable, p->kstack, (uint64)kvmpa(p->kstack), PGSIZE, PTE_R | PTE_W);
return kpagetable;
}这里没有用
kvmmap去映射 CLINT ,因为 CLINT 只有在内核启动时在 M 态被访问过,后期 CPU 不再以 M 态运行,操作系统也不会再直接访问这一块虚拟地址,因此也没有必要映射。另外原版的
kvmmap内部默认使用kernel_pagetable,所以需要修改函数签名使其能够接受进程专属的内核页表拷贝。void kvmmap(pagetable_t pagetable, uint64 va, uint64 pa, uint64 sz, int perm) { if(mappages(pagetable, va, sz, pa, perm) != 0) panic("kvmmap"); }
提示让我们将映射内核栈的逻辑从 procinit 中迁移。但是我看 procinit 操作的是 kernel_pagetable 全局内核页表,后续进入用户空间后每一次进入系统内核都直接使用进程的 kpagetable ,也不会再使用到 kernel_pagetable 了。保留的成本为 0 ,也没必要删除。
接下来修改进程调度器 scheduler ,使得在进入进程后将 SATP 指向进程自有的内核页表副本。原本 SATP 是一直指向 kernel_pagetable 的,这也是内核无法直接解引用用户指针的根源。只需要在 swtch 函数前后加上以下几行即可:
w_satp(MAKE_SATP(p->kpagetable));
sfence_vma();
swtch(&c->context, &p->context);
kvminithart();
kvminithart 用于在进程结束但还没有调度新进程时切换为全局内核页表。
释放进程需要释放 kpagetable 的页表,但是不能直接释放最终指向的物理页,这应该由 proc_freepagetable 负责,所以需要声明一个新的 proc_freekpagetable 函数。
void
proc_freekpagetable(pagetable_t kpagetable)
{
  for(int i = 0; i < 512; i++) {
    uint64 pte = kpagetable[i];
    if(pte & PTE_V) {
      if((pte & (PTE_R|PTE_W|PTE_X)) == 0) {
        proc_freekpagetable((pagetable_t) PTE2PA(pte));
      }
      kpagetable[i] = 0;
    }
  }
  kfree((void*) kpagetable);
}
这个函数体的实现要求 PTE 的 PTE_R、PTE_W、PTE_X 位都为 0 才会递归进入下一级,而叶子表项上映射真实物理页号的相同标志位则不会这样。
在 freeproc 中调用该函数即可。
static void
freeproc(struct proc *p)
{
  if(p->trapframe)
    kfree((void*)p->trapframe);
  p->trapframe = 0;
  if(p->pagetable)
    proc_freepagetable(p->pagetable, p->sz);
  if(p->kpagetable)
    proc_freekpagetable(p->kpagetable);
  p->kpagetable = 0;
  p->pagetable = 0;
  p->sz = 0;
  p->pid = 0;
  p->parent = 0;
  p->name[0] = 0;
  p->chan = 0;
  p->killed = 0;
  p->xstate = 0;
  p->state = UNUSED;
}
[hard] Simplify copyin/copyinstr
前面一节中,实现了进程在创建时获得内核页表、释放时清除内核页表。但是想要内核能够直接解引用用户指针,需要进程的内存空间每次发生改变时都需要同步到内核页表上。本节的目标就是在用户进程内存发生改变(比如调用 fork 、sbrk 等)时进行内核页表的同步。
将
kernel/vm.c中copyin的函数体替换为对copyin_new(定义在kernel/vmcopyin.c中)的调用;对copyinstr也做同样的处理,改为调用copyinstr_new。为每个进程的内核页表添加用户地址的映射,以便copyin_new和copyinstr_new能够正常工作。如果usertests能正确运行,并且所有make grade测试都能通过,你就通过了这次作业。
先把
copyin()替换为对copyin_new()的调用,并让它正常工作,然后再继续处理copyinstr。
在内核每次修改某个进程的用户映射时,也要以同样的方式修改该进程的内核页表。这类位置包括
fork()、exec()和sbrk()。
不要忘记在
userinit中把第一个进程的用户页表也包含进它的内核页表。
进程内核页表中,用户地址对应的 PTE 需要什么权限?(设置了
PTE_U的页在内核模式下不能被访问。)
不要忘记前面提到的 PLIC 限制。
按照任务要求,将 copyin 和 copyinstr 的实现改变位对 copyin_new 和 copyinstr_new 的调用(两个新函数的实现已给出不需要自己实现)。
int
copyin(pagetable_t pagetable, char *dst, uint64 srcva, uint64 len)
{
return copyin_new(pagetable, dst, srcva, len);
}
int
copyinstr(pagetable_t pagetable, char *dst, uint64 srcva, uint64 max)
{
return copyinstr_new(pagetable, dst, srcva, max);
}fork
在 fork 中,新的进程应当完全拷贝一份父进程的内核页表。原始的 fork 函数使用 uvmcopy 进行子进程对父进程用户页表的拷贝。
// Copy user memory from parent to child.
if(uvmcopy(p->pagetable, np->pagetable, p->sz) < 0){
  freeproc(np);
  release(&np->lock);
  return -1;
}
uvmcopy 的具体逻辑拉出来单放在下面,此处我们需要在该函数映射父进程虚拟内存时也将其映射到内核页表上,因此需要修改函数签名使其接受 new_kpg 变量。
if(mappages(new, i, PGSIZE, (uint64)mem, flags) != 0){
  kfree(mem);
  goto err;
}
if(mappages(new_kpg, i, PGSIZE, (uint64)mem, flags & ~PTE_U) != 0){
  uvmunmap(new, i, 1, 1);
  goto err;
}
映射内核页表时传入的 flag 由于是从父进程的虚拟地址得到的,
PTE_U位为 1 。在内核页表中我们希望这个地址只有内核能够访问,所以会清除这个标志位。如果走到映射内核页表的时候产生了错误,由于前面
mem这一块物流页已经被映射了,直接调用kfree会导致用户页表指向已释放的物理页,因此需要先解除映射。uvmunmap的最后一个参数传入 1 会同时释放这一块物理页。
sbrk
sbrk 系统调用用于拓展原进程的堆空间,该系统调用会调用 growproc ,growproc 又调用了 uvmalloc 和 uvmdealloc 进行申请、释放内存空间,所以修改的重点在于 uvmalloc 和 uvmdealloc 。
if (n > 0) {
    if ((sz = uvmalloc(p->pagetable, sz, sz + n)) == 0) {
        return -1;
    }
} else if (n < 0) {
    sz = uvmdealloc(p->pagetable, sz, sz + n);
}
首先肯定是先把两个函数的签名修改了,使其能够接受内核页表。在 uvmalloc 中新增逻辑,在用户页表完成映射后映射到内核页表上。注意 PTE_U 不需要置位。
if(mappages(pagetable, a, PGSIZE, (uint64)mem, PTE_W|PTE_X|PTE_R|PTE_U) != 0){
  kfree(mem);
  uvmdealloc(pagetable, kpagetable, a, oldsz);
  return 0;
}
if(kpagetable && mappages(kpagetable, a, PGSIZE, (uint64)mem, PTE_W|PTE_X|PTE_R) != 0) {
  uvmunmap(pagetable, a, 1, 1);
  uvmdealloc(pagetable, kpagetable, a, oldsz);
  return 0;
}
然后是 uvmdealloc ,在用户页表释放后照葫芦画瓢即可。
if(PGROUNDUP(newsz) < PGROUNDUP(oldsz)){
    int npages = (PGROUNDUP(oldsz) - PGROUNDUP(newsz)) / PGSIZE;
    uvmunmap(pagetable, PGROUNDUP(newsz), npages, 1);
    if(kpagetable)
      uvmunmap(kpagetable, PGROUNDUP(newsz), npages, 0);
}
这里
uvmalloc和uvmdealloc都对kpagetable进行了判空,这样能够允许两个函数传入空的内核页表,有利于下面对exec的修改。因为在exec中需要不断申请内存映射 elf 文件中的各种段,还要分配两页的栈空间。原始的exec会先将旧的用户页表保留,然后创建新的用户页表进行映射,如果在映射期间出现了错误,可以立即使用proc_freepagetable弃用刚创建的页表,旧进程继续使用原页表。这种方式不太适用进程的内核页表,因为前面的用户页表是在完全重建,而对于
exec来说进程还是当前进程只是执行的文件不一样了,前面的内核栈、trapframe等关键信息还是可以复用的。所以在后面进行exec的修改时思路是等用户页表完全重建完成后,将内核页表的用户地址范围覆盖了即可。
exec
按照前面的思路,在 exec 中出现 uvmalloc 或 uvmdealloc 需要传入内核页表的地方传入空值,最后在 commit 阶段将原内核页表的用户地址范围解除映射,再将新的用户页表映射即可。
// Commit to the user image.
oldpagetable = p->pagetable;
p->pagetable = pagetable;
p->sz = sz;
uvmunmap(p->kpagetable, 0, PGROUNDUP(oldsz)/PGSIZE, 0);
for(uint64 a = 0; a < sz; a += PGSIZE){
pte_t *pte = walk(pagetable, a, 0);
if(pte == 0 || (*pte & PTE_V) == 0) panic("exec: hole in new pagetable");
if(mappages(p->kpagetable, a, PGSIZE, PTE2PA(*pte), PTE_FLAGS(*pte) & ~PTE_U) != 0)
panic("exec: kpagetable");
}
p->trapframe->epc = elf.entry; // initial program counter = main
p->trapframe->sp = sp; // initial stack pointer
proc_freepagetable(oldpagetable, oldsz);这里也别忘了将 PTE_U 位置零。
userinit
userinit 中往第一个进程的用户页表映射了 initcode ,由于这个进程是由操作内核创建的,前面修改的 fork 、sbrk 都无法作用于它,很容易被遗忘。
uvminit(p->pagetable, initcode, sizeof(initcode));
if(mappages(p->kpagetable, 0, PGSIZE, (uint64)walkaddr(p->pagetable, 0), PTE_W|PTE_R|PTE_X) != 0)
  panic("userinit: kpagetable");
p->sz = PGSIZE;
Q&A
凭什么认为多级页表设计优于单级平坦页表?
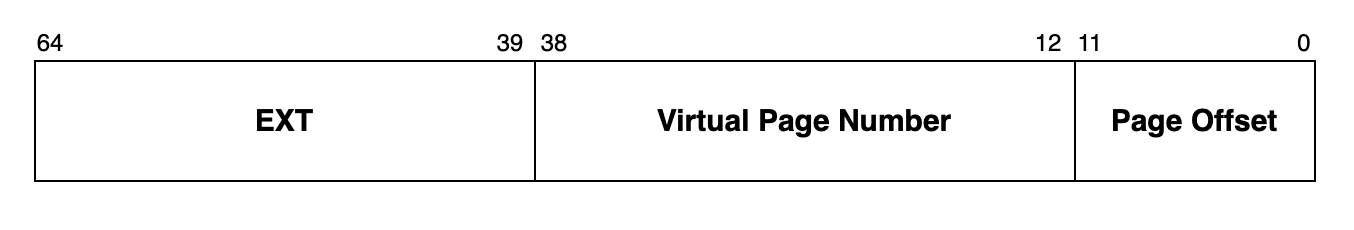
以下假设使用 Sv39 的虚拟地址格式。对于单级平坦页表,每一个虚拟地址结构的 0~11 位为页内偏移 Page Offset ,第 12~31 位为虚拟页号 VPN 。
Sv39 指 64 位下一个虚拟地址的低 39 位可以用于进行虚拟地址转换,39~64 位为 ext 符号拓展,用于保证 39 位的有效数据在拓展为 64 位后保证正负不变,这也是计算机系统组成概论课程中的一个小知识点。
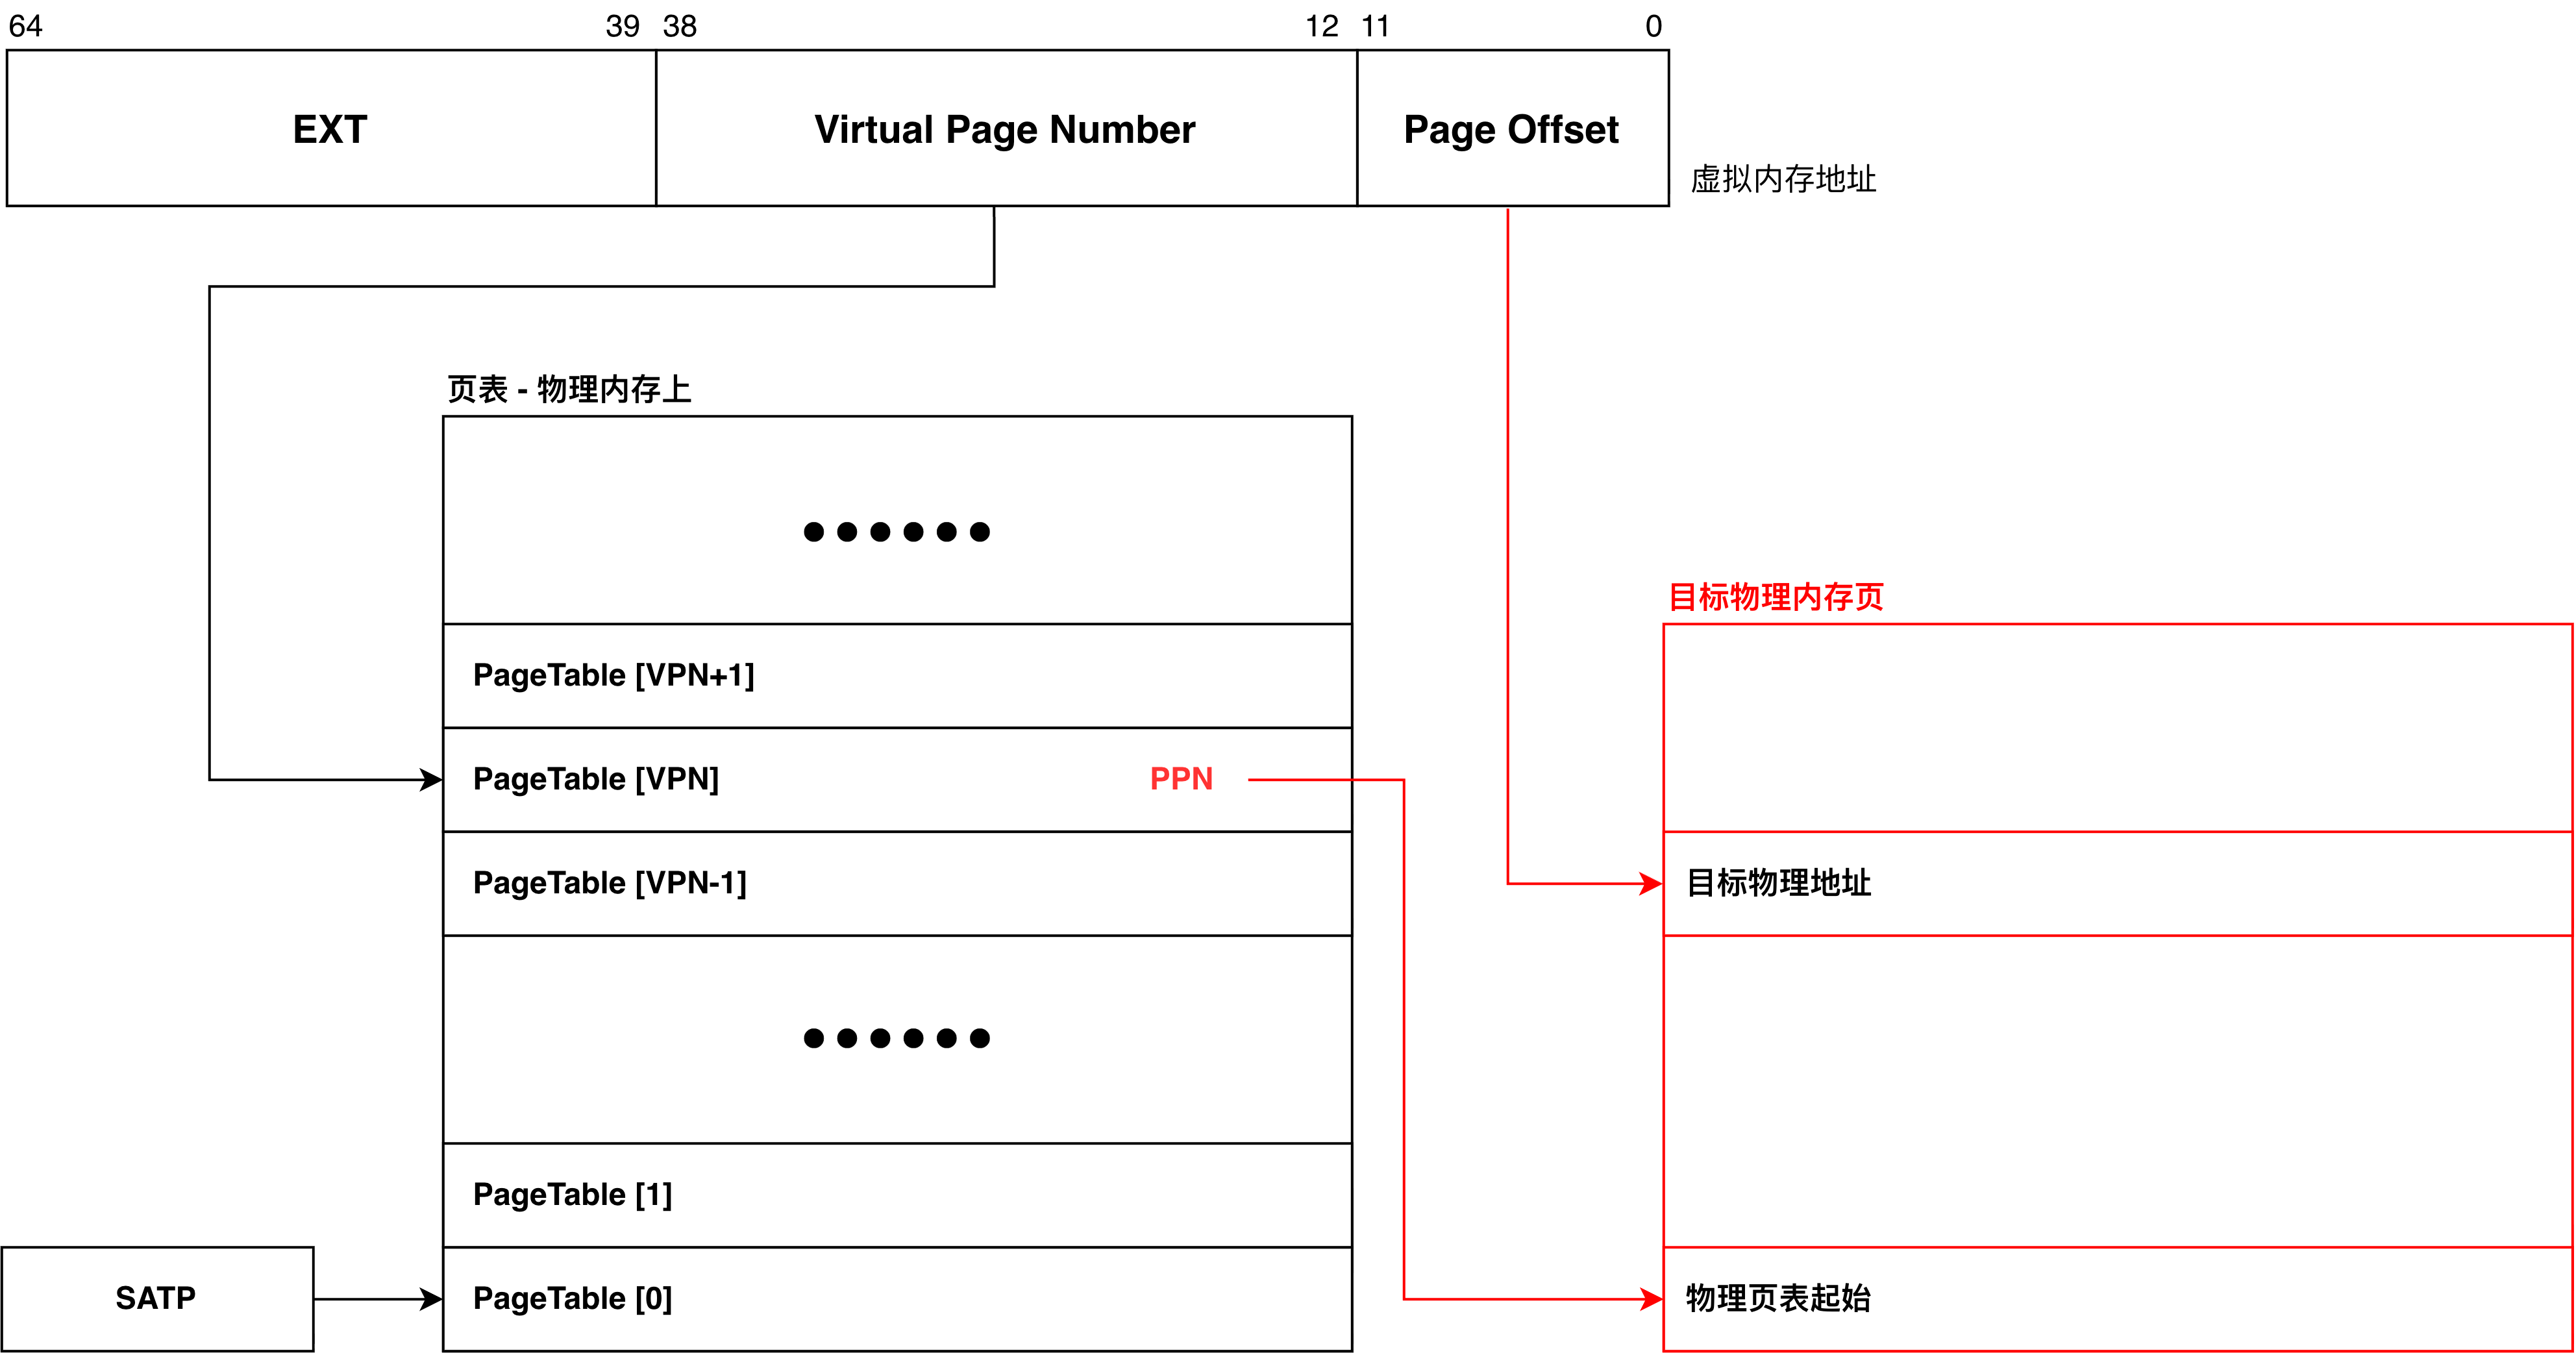
使用 VPN 可以直接对应到页表中的 PTE ,再通过 PTE 找到 PPN ,得到物理页号后加上偏移就能找到物理地址。所以使用单级平坦页表的查找效率很高,每次进行虚拟地址转换都只用查询一次页表。
但是问题也很明显,物理内存上需要为每一个可能的 VPN 都预留一个 PTE ,也就是 2^27 个条目,按照每个 PTE 占据 8B 的空间计算,光是为了放下一个页表每个进程就需要 2^27 * 8B = 1GiB 的物理内存。哪怕一个进程只有一个虚拟地址被映射了,也需要消耗如此之多的物理内存,这样就造成了大量的内存浪费。
造成上述问题的根本原因是连续。使用单级平坦页表进行虚拟地址转换,在硬件层面其实是一个“基地址+偏移”的寻址模式,也就是说整个页表就是一个大数组,SATP 寄存器存储的页表基地址就是基地址,VPN 则为偏移。
早些时候我并不理解为什么物理内存上一定非要提前申请那么大的内存空间给页表,难道不能随用随申请吗?我之所以这么想是因为在多级页表中如果某一级别的页表未被映射,此时会触发缺页错误然后内核去处理申请空间并配置映射。那么我就认为如果单级页表也适用类似的方式不行吗?
后面仔细想想发现没有意义。首先程序运行时,虚拟地址的 VPN 是多样的,并且不能保证连续。这样肯定会在页表中产生很多空洞,而这些空洞是没有利用价值的,因为完全不知道下一个要进行转换的地址会用到哪一个 PTE 。所以硬件上就需要预留出整个 1GiB 的页表。
接下来看多级页表的实现,这种情况下虚拟地址的结构会有所不同,主要是 VPN 被拆分成了三个部分,每个部分 9 位,合并还是 27 位。
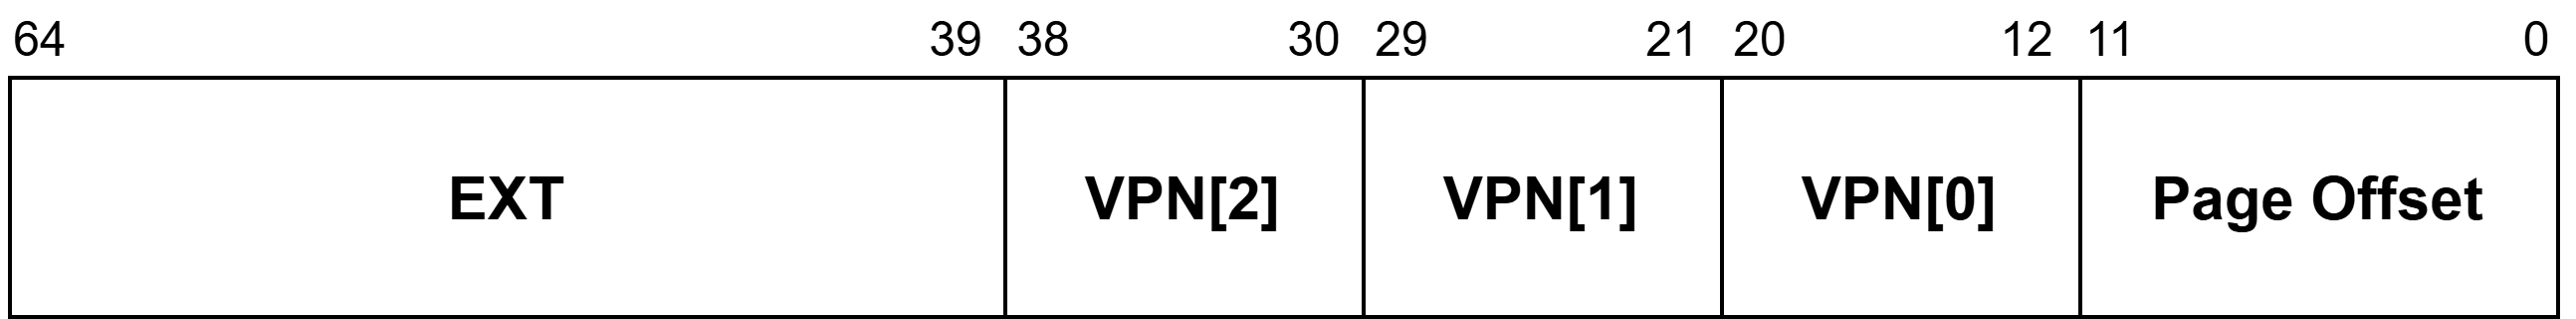
转换的过程核心没变,还是基址加偏移那一套。首先使用 SATP 寄存器提供的顶层页表基地址,将 VPN[2] 作为下标找到对应的 PTE ,但此 PTE 对应的 PPN 并不是最终要找的物理地址,而是指向下一级页表的基地址。使用上一次查询的基地址配合 VPN[1] 作为下标就能找到第三级页表的基地址。在第三级页表使用 VPN[0] 进行一次查询,此处 PTE 对应的 PPN 才是虚拟地址真正对应的物理地址页号。
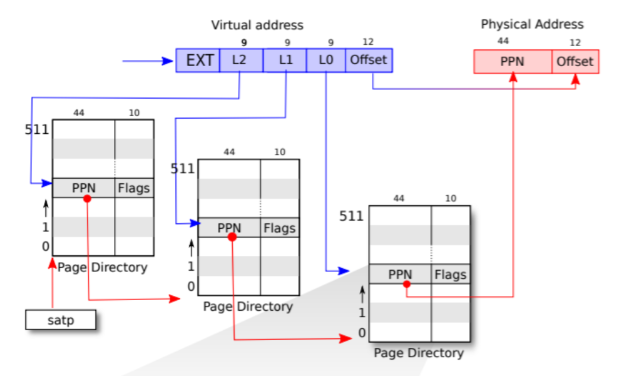
第一级页表可以索引 2^9 = 512 个二级页表,同样的每一个二级页表都可以索引 512 个三级页表,每一个三级页表可以索引 512 个物理页号,最多能够索引的物理页号仍然是 2^27 个。那么这个设计为什么可以减少页表对物理内存的占用?核心就在于页表不再连续。这样就可以只创建有映射的虚拟地址,如果有新的虚拟地址被映射而对应的页表没有被创建,内核通过申请空间新建页表、将该页表的指针写入上一级页表的 PTE 即可。
简单对比,使用单级平坦页表不论实际使用了多少个虚拟地址,都需要完全准备 1GiB 的物理空间。而使用多级页表只有在最极限的情况才会使用这么大的物理内存空间,而且这种情况几乎不可能达到。比如使用多级页表的情况下,有一个虚拟地址被使用,此时只需要三级页表各存在一个即可,占据的空间只有 3 512 8B = 12KiB 。
walk 函数的逻辑?
walk 函数用于负责将给定的一个顶级页表的 PTE 转换为最终页表的 PTE ,该函数的实现原型如下
pte_t *
walk(pagetable_t pagetable, uint64 va, int alloc)
{
if(va >= MAXVA)
panic("walk");
for(int level = 2; level > 0; level--) {
pte_t *pte = &pagetable[PX(level, va)];
if(*pte & PTE_V) {
pagetable = (pagetable_t)PTE2PA(*pte);
} else {
if(!alloc || (pagetable = (pde_t*)kalloc()) == 0)
return 0;
memset(pagetable, 0, PGSIZE);
*pte = PA2PTE(pagetable) | PTE_V;
}
}
return &pagetable[PX(0, va)];
}walk 会首先检验传入的虚拟地址 va 是否合法(在 MAXVA 即用户虚拟地址空间上限内),然后进入一个循环。该循环默认传入的 pagetable 为顶级页表,所以会进行两次循环,两次循环后 pagetable 已经指向最后一级页表,最后使用 &pagetable[PX(0, va)] 取出目标 PPN 。
PX 宏用于从虚拟地址 va 中取出对应页表等级的偏移,比如 PX(2, va) 就是从虚拟地址 va 中取出 VPN[2] 的部分。最后的 &pagetable[PX(0, va)]
PTE_V 这个宏代展开就是一个 1L 的数值,因为 PTE_V 这个标志位就在虚拟地址的第 0 位,将这个宏与给定的 PTE 进行与运算就能知道这个 PTE 该标志位的情况。类似的还有 PTE_R、PTE_X 等,只是右移的位数不同。
PTE2PA 宏根据 PTE 的结构取出计算出当前 PTE 指向的物理地址。右移 10 位清除标志位,然后左移 12 位即可,即 4096 对齐。
#define PTE2PA(pte) (((pte) >> 10) << 12)
当 walk 发现某个 PTE 的 PTE_V 位未设置,说明此 PTE 尚未分配物理内存页。如果传入的参数 alloc 不为 0 ,代表调用者希望在 walk 检查到缺页时能够自动申请空间去建立页表。否则返回 0 ,相当于上报缺页问题。
mappages 函数的逻辑?
mappages 函数用于对给定的页表和虚拟地址建立物理地址映射,其完整实现如下:
int
mappages(pagetable_t pagetable, uint64 va, uint64 size, uint64 pa, int perm)
{
uint64 a, last;
pte_t *pte;
a = PGROUNDDOWN(va);
last = PGROUNDDOWN(va + size - 1);
for(;;){
if((pte = walk(pagetable, a, 1)) == 0)
return -1;
if(*pte & PTE_V)
panic("remap");
*pte = PA2PTE(pa) | perm | PTE_V;
if(a == last)
break;
a += PGSIZE;
pa += PGSIZE;
}
return 0;
}mappages 按照一个页(也就是 4KiB )的虚拟地址大小为粒度进行映射,只对该页的头地址进行(因为同一虚拟页上的虚拟地址的 VPN[0]、VPN[1]、VPN[2] 都是相同的)。调用 walk 后获得最后一级页表的 PTE 地址,然后将物理页号、标志位写入。
函数要求传入的虚拟地址都不应存在映射。如果发现该页最后 PTE 的标志位 PTE_V 为 1 则会触发内核恐慌。
if(*pte & PTE_V) panic("remap");